Kaggle猫狗分类问题
使用更大的数据集训练:猫狗数据集
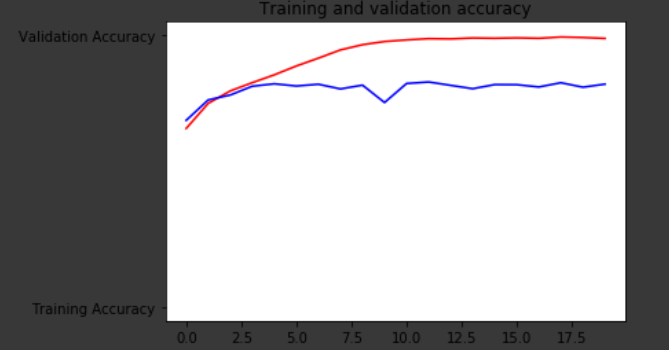
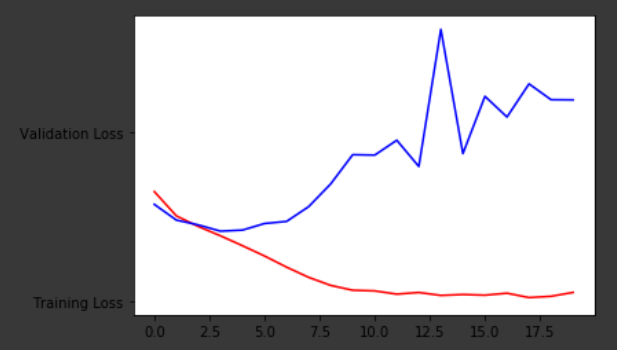
在先前的实验中,使用了horse-humans数据集训练了分类器。可以看到,尽管获得了不错的训练效果,但是当尝试对真实图像进行分类时,仍然存在许多错误,这主要是由于过拟合:网络在处理以前看到的数据时表现很好,而在处理没过的的数据时表现很差!
在本实验中,你将查看一个真实的非常大的数据集,并了解大数据集对于避免过度拟合的影响。
- 导入必要库
import os
import zipfile
import random
import tensorflow as tf
from tensorflow.keras.optimizer import RMSprop
from tensorflow.keras.preprocessing.image import ImageDtaGenerator
from shutil import copyfile
- 下载、解压数据集
# 如果下载失败,可以在这里下载https://www.microsoft.com/en-us/download/confirmation.aspx?id=54765
# 数据集比较大,需要花点时间
# 开始下载
!wget --no-check-certificate \
    "https://download.microsoft.com/download/3/E/1/3E1C3F21-ECDB-4869-8368-6DEBA77B919F/kagglecatsanddogs_3367a.zip" \
    -O "/tmp/cats-and-dogs.zip"

local_zip = '/tmp/cats-and-dogs.zip'
zip_ref   = zipfile.ZipFile(local_zip, 'r')
# 解压到'/tmp'文件夹
zip_ref.extractall('/tmp')
zip_ref.close()
- 输出猫、狗图片数量
print(len(os.listdir('/tmp/PetImages/Cat/')))
print(len(os.listdir('/tmp/PetImages/Dog/')))
# 输出猫、狗图片数量
# 12501
# 12501
- 创建训练和测试文件夹
try:
    os.mkdir('/tmp/cats-v-dogs')
    os.mkdir('/tmp/cats-v-dogs/training')
    os.mkdir('/tmp/cats-v-dogs/testing')
    os.mkdir('/tmp/cats-v-dogs/training/cats')
    os.mkdir('/tmp/cats-v-dogs/training/dogs')
    os.mkdir('/tmp/cats-v-dogs/testing/cats')
    os.mkdir('/tmp/cats-v-dogs/testing/dogs')
except OSError:
    pass
- 筛选不合格图片,将数据集混合后按9:1划分训练集和测试集
def split_data(SOURCE, TRAINING, TESTING, SPLIT_SIZE):
    files = []
    # 图片大小为0的筛出
    for filename in os.listdir(SOURCE):
        file = SOURCE + filename
        if os.path.getsize(file) > 0:
            files.append(filename)
        else:
            print(filename + " is zero length, so ignoring.")
	# 训练集数量90%
    training_length = int(len(files) * SPLIT_SIZE)
    # 测试集数量10%
    testing_length = int(len(files) - training_length)
    # 随机混合
    shuffled_set = random.sample(files, len(files))
    # 训练集取随机后的前90%的数量
    training_set = shuffled_set[0:training_length]
    # 测试集取随机后的后10%的数量
    testing_set = shuffled_set[-testing_length:]

	# 复制到新建的训练文件夹
    for filename in training_set:
        this_file = SOURCE + filename
        destination = TRAINING + filename
        copyfile(this_file, destination)
	# 复制到新建的测试文件夹
    for filename in testing_set:
        this_file = SOURCE + filename
        destination = TESTING + filename
        copyfile(this_file, destination)

# 定义一些存储位置
CAT_SOURCE_DIR = "/tmp/PetImages/Cat/"
TRAINING_CATS_DIR = "/tmp/cats-v-dogs/training/cats/"
TESTING_CATS_DIR = "/tmp/cats-v-dogs/testing/cats/"
DOG_SOURCE_DIR = "/tmp/PetImages/Dog/"
TRAINING_DOGS_DIR = "/tmp/cats-v-dogs/training/dogs/"
TESTING_DOGS_DIR = "/tmp/cats-v-dogs/testing/dogs/"

# 调用函数
split_size = .9
split_data(CAT_SOURCE_DIR, TRAINING_CATS_DIR, TESTING_CATS_DIR, split_size)
split_data(DOG_SOURCE_DIR, TRAINING_DOGS_DIR, TESTING_DOGS_DIR, split_size)

# 输出:
# 666.jpg is zero length, so ignoring
# 11702.jpg is zero length, so ignoring
- 输出整理后的训练集和测试集中图片数量
print(len(os.listdir('/tmp/cats-v-dogs/training/cats/')))
print(len(os.listdir('/tmp/cats-v-dogs/training/dogs/')))
print(len(os.listdir('/tmp/cats-v-dogs/testing/cats/')))
print(len(os.listdir('/tmp/cats-v-dogs/testing/dogs/')))

# 输出:
# 11250
# 11250
# 1250
# 1250
- 开始构建卷积神经网络模型
model = tf.keras.models.Sequential([
	# 卷积1
	tf.keras.models.layers.Conv2D(16,(3,3),activation='relu',input_shape=(150,150,3)),
	# 池化1
	tf.keras.layers.MaxPooling2D(2,2),
	# 卷积2
	tf.keras.layers.Conv2D(32,(3,3),activation='relu'),
	# 池化2
	tf.keras.layers.MaxPooling(2,2),
	# 卷积3
	tf.keras.layers.Conv2D(64,(3,3),activation='relu'),
	# 池化3
	tf.leras.layers.MaxPooling(2,2),
	# 展平
	tf.karas.layers.Flatten(),
	# 全连接神经元
	tf.keras.layers.Dense(512, activation='relu'),
	# sigmoid分类激活
	tf.keras.layers.Dense(1, activation='sigmoid')
	])

# 配置优化器和损失函数
model.compile(optimizer=RMSprop(lr=0.001),
	loss = 'binary_crossentropy',
	metrics = ['acc']
	)
- 进行数据归一化处理
TRAINING_DIR = "/tmp/cats-v-dogs/training/"
train_datagen = ImageDataGenerator(rescale=1.0/255.)
train_generator = train_datagen.flow_from_directory(TRAINING_DIR,
                                                    batch_size=100,
                                                    class_mode='binary',
                                                    target_size=(150, 150))

VALIDATION_DIR = "/tmp/cats-v-dogs/testing/"
validation_datagen = ImageDataGenerator(rescale=1.0/255.)
validation_generator = validation_datagen.flow_from_directory(VALIDATION_DIR,
                                                              batch_size=100,
                                                              class_mode='binary',
                                                              target_size=(150, 150))

# 输出:
# Found 22498 images belonging to 2 classes.
# Found 2500 images belonging to 2 classes.
- 开始训练分类模型
# 共15个epochs,需要一些时间.
history = model.fit_generator(train_generator,
                              epochs=20,
                              verbose=1,
                              validation_data=validation_generator)
这里要注意model的.fit()函数和.fit_generator()区别:
对于小型,简单化的数据集,使用Keras的.fit函数是完全可以接受的。
这些数据集通常不是很具有挑战性,不需要任何数据增强。
但是,真实世界的数据集很少这么简单:
真实世界的数据集通常太大而无法放入内存中
它们也往往具有挑战性,要求我们执行数据增强以避免过拟合并增加我们的模型的泛化能力
在这些情况下,我们需要利用Keras的.fit_generator函数:
# 我们首先初始化将要训练的网络的epoch和batch size。
EPOCHS = 100
BS = 32

# construct the training image generator for data augmentation
aug = ImageDataGenerator(rotation_range=20, zoom_range=0.15,
	width_shift_range=0.2, height_shift_range=0.2, shear_range=0.15,
	horizontal_flip=True, fill_mode="nearest")

# train the network
H = model.fit_generator(aug.flow(trainX, trainY, batch_size=BS),
	validation_data=(testX, testY), steps_per_epoch=len(trainX) // BS,
	epochs=EPOCHS)
- 绘制训练过程曲线
%matplotlib inline

import matplotlib.image  as mpimg
import matplotlib.pyplot as plt

#-----------------------------------------------------------
# 返回每个epochs训练过程中训练集和测试集的结果
#-----------------------------------------------------------
acc=history.history['acc']
val_acc=history.history['val_acc']
loss=history.history['loss']
val_loss=history.history['val_loss']

epochs=range(len(acc)) # Get number of epochs

#------------------------------------------------
# 绘制每个epoch训练和验证的准确性
#------------------------------------------------
plt.plot(epochs, acc, 'r', "Training Accuracy")
plt.plot(epochs, val_acc, 'b', "Validation Accuracy")
plt.title('Training and validation accuracy')
plt.figure()

#------------------------------------------------
# 绘制每个epoch训练和验证的损失
#------------------------------------------------
plt.plot(epochs, loss, 'r', "Training Loss")
plt.plot(epochs, val_loss, 'b', "Validation Loss")
plt.figure()
- 使用
model.predict()测试自己的图片
# 注:如果是本地编译器或者非colab,需要简单需改图片路径指向了。
import numpy as np
from google.colab import files
from keras.preprocessing import image

uploaded = files.upload()

for fn in uploaded.keys():

  # predicting images
  path = '/content/' + fn
  img = image.load_img(path, target_size=(150, 150))
  x = image.img_to_array(img)
  x = np.expand_dims(x, axis=0)

  images = np.vstack([x])
  classes = model.predict(images, batch_size=10)
  print(classes[0])
  if classes[0]>0.5:
    print(fn + " is a dog")
  else:
    print(fn + " is a cat")
结果输出: