- 第一节:机器学习与人工智能
- 1.创建你的第一个神经网络
- 第二节: 机器学习中的基本计算机视觉概念
- 第三节:卷积神经网络
- 第四节:使用卷积提高计算机视觉精度
- 第五节:对复杂图像使用卷积
- 第六节:可视化中间表示
- 清理
课程视频链接:机器学习从零到一
由于部分图片使用了来自colab的资源,对于大陆ip加载这些图片可能需要使用代理
第一节:机器学习与人工智能
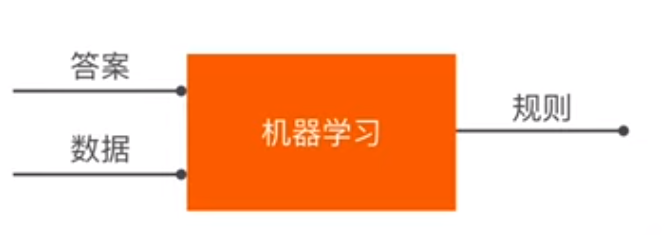
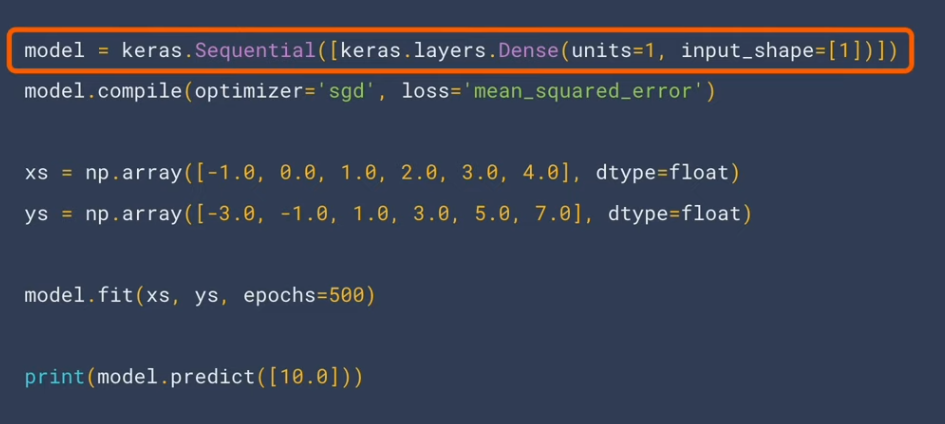
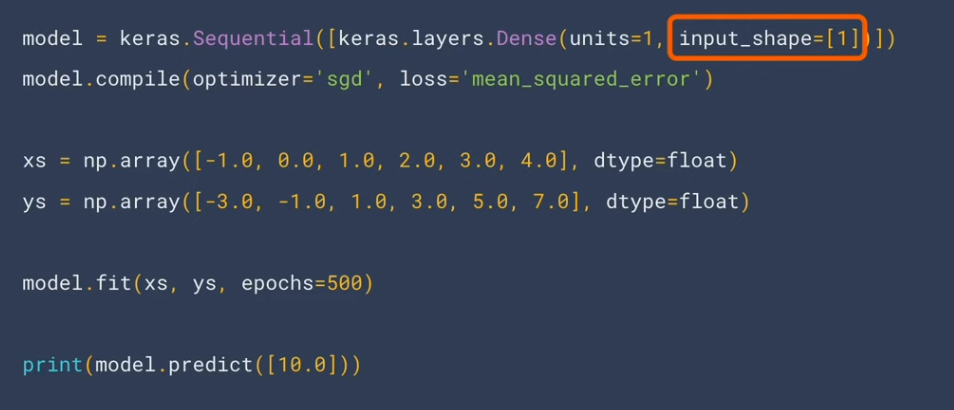
使用keras.layers.Dense定义的单层神经网络。这个圣经网络中只有一个神经元,所有units的值为1;把单个的数据放入神经网络中,这就是x的值,如下,input_shape,就是输入值的形状,如下:
编译时定义两个函数:损失函数(loss)和优化函数(optimizer)。损失函数决定模型的好坏,优化函数决定模型的收敛方式,如下:
model.fit模型会经过500次的循环,猜测一个值,然后由损失函数和优化函数优化猜测的值,理论上猜测会越来越准确。如下:
结束训练以后就可以使用模型的model.predict基于x值来预测新的y值,比如x=[10.0]:如下:
1.创建你的第一个神经网络
考虑以下几组数字。你看到他们之间的关系了吗?
| X: | -1 | 0 | 1 | 2 | 3 | 4 |
|---|---|---|---|---|---|---|
| Y: | -2 | 1 | 4 | 7 | 10 | 4 |
很容易观察得出 :Y=3X+1的关系。
那么,如何通过训练神经网络来完成这个工作呢?通过喂给它一组X和一组Y,应该能够弄清楚它们之间的关系。这可能与你的习惯不太一样。
第一步:设置环境
设置python环境,安装tensorflow,新建一个python文件,在这里我们导入Tensorflow并将其称为tf,以易于使用。接下来导入一个名为numpy的库,该库可以帮助我们轻松快速地将数据表示为列表。将神经网络定义为一组顺序层的框架成为keras,因此我们也将其导入。
import tensorflow as tf
import numpy as np
from tensorflow import keras
第二步:定义和编译神经网络
接下来我们来创建最简单的神经网络:它具有1层,并且该层具有1个神经元,并且输入形状为1值。
model=tf.keras.Sequential([keras.layers.Dense(units=1,input_shape=[1])])
接下来我们将编写代码来编译我们的神经网络。
我们需要先指定两个函数,一个损失函数(loss),一个优化函数(optimizer)。
在解决数字之间的关系为y = 3x + 1时,当计算机试图“学习”时,就会做出猜测……也许是“ y = 10x + 10”。损失函数针对已知的正确答案来衡量猜测的答案,并衡量其效果如何或有多差。
接下来,模型使用优化函数进行另一个猜测。根据损失函数的结果,它将尝试使损失最小化。在这一点上,它可能会提出类似“ y = 5x + 5”的内容。尽管这仍然很糟糕,但更接近正确的结果(即损失更低)。
该模型将针对您将很快看到的纪元数重复此操作。
model.compile(optimizer='sgd', loss='mean_squared_error')
第三步:提供训练数据
接下来我们将6个x和对应的6个y当作输入的数据。
名为numpy的python库提供了许多数组类型的数据结构,这是事实上的标准方法。我们声明我们想通过使用np.array []将值指定为numpy中的数组来使用它们。
xs=np.array([-1.0, 0.0, 1.0, 2.0, 3.0, 4.0],dtype=float)
ys=np.array([-2.0, 1.0, 4.0, 7.0, 10.0, 13.0],dtype=float)
现在,你已经编写了定义神经网络所需的所有代码。下一步将是对其进行训练,以查看它是否可以推断这些数字之间的模式,并使用它们来创建模型。
第四步:训练你的神经网络
训练神经网络的过程实在model.fit调用的,它学习xs和ys之间的关系。这就是我们前面说的循环的地方:进行猜测,测量其好坏(也称为损失),使用优化程序进行另一次猜测等,它将针对你设置的循环次数(epochs)执行此操作。运行此代码时,您会看到损失将在每个时期打印出来。
model.fit(xs,ys,epochs=500)
因此,例如,可以在此处看到在前几个时期,损耗值很大,但是每一步的损耗值都越来越小:

随着训练的进行,损失很快就会变得很小:

到训练结束时,损失非常小,表明我们的模型在推断数字之间的关系方面做得很好:

您可能不需要全部500个循环epochs,并且可以尝试不同的数量,但是从本示例中可以看到,仅50个epochs后损失确实很小,所以这足够了!
第五步:使用训练出的模型进行预测
好的,现在已经有一个训练有素的模型可以学习X和Y之间的关系。您可以使用model.predict方法让它找出以前未知的X的Y。例如,如果X = 10,你认为Y会是什么?运行此代码之前,请先猜测一下:
print(model.predict([10.0]))
您可能会认为最终猜测值会是31,但是最终预测值可能有点偏差。
因为神经网络处理概率,因此在给我们提供神经网络的数据的基础上,它计算出X和Y之间的关系为Y = 3X + 1的可能性非常高,但是只有6个数据点我们无法得到对于未知数据的确切结果。结果,10的结果非常接近31,但不一定是31。
第二节: 机器学习中的基本计算机视觉概念
让我们看一个场景,在该场景中,我们可以识别出不同的衣服,这些衣服是从包含10种不同类型的数据集中训练出来的。
一个数据集fashion MNIST :
10个种类、10k图像、图像尺寸28X28、就足够训练一个神经网络
- 我们将训练一个神经网络,以从称为Fashion MNIST的通用数据集中识别服装。
- 它包含10种不同类别的70,000件衣物。每件衣服都是28x28灰度图像。

- 可在tf.keras数据集API中直接获得Fashion MNIST数据。直接使用
mnist = tf.keras.datasets.fashion_mnist就可以获取数据集。 - 在此对象上调用load_data将为您提供两组两个列表,这两个列表将是包含服装项目及其标签的图形的训练和测试值。
(training_images, training_labels),(test_images, test_labels) = mnist.load_data() - 这些值是什么样的?让我们打印一个训练图像和一个训练标签以查看…具有数组中不同索引的实验。例如,还要看一下索引42 …那是与索引0的引导不同的引导。
-
import matplotlib.pyplot as plt plt.imshow(training_images[0]) print(training_labels[0]) print(training_images[0]) - 您会注意到,数字中的所有值都在0到255之间。如果我们在训练神经网络,出于各种原因,将所有值都视为0到1之间的过程会更容易,这一过程称为“规范化”。幸运的是,在Python中,无需循环就可以很容易地标准化这样的列表。您可以这样操作:
-
training_images = training_images / 255.0 test_images = test_images / 255.0 - 现在你可能想知道为什么会有2个数据集:训练集和测试集-记得我们在介绍中谈到过吗?这个想法是要有一组要训练的数据,然后是另一组数据是该模型尚未见过的,看它在对未见过的值进行分类方面有多好。毕竟,完成之后,将想要使用以前从未见过的数据进行尝试!
- 现在让我们设计模型。
-
model = tf.keras.model.Sequential([tf.keras.layers.Flatten(), tf.keras.layers.Dense(128, activation=tf.nn.rule), tf.keras.layers.Dense(10, activation=tf.nn.softmax)]) Sequential:定义了神经网络中各层的顺序Flatten:展平只是获取该正方形图像并将其变成一维集Dense:全连接层:增加一层神经元,每层神经元都需要激活功能来告诉他们该做什么。Softmax:Softmax采用一组值,并有效地选择最大的值。它使你免于寻找最大价值的麻烦,并将其变成像[0,0,0,0,1,0,0,0,0],节省代码- 模型定义好了的下一步是实际构建模型。您可以像以前一样使用优化器和损失函数对其进行编译,然后通过调用* model.fit *对其进行训练,要求其将训练数据适合您的训练标签-即让其找出两者之间的关系。训练数据及其实际标签,因此在将来,如果您拥有看起来像训练数据的数据,则可以预测该数据的样子。
-
model.compile(optimizer = tf.train.AdamOptimmizer(), loss = 'aparse_categorical_crossentropy', metrics = ['accuracy']) model.fit(training_images, training_labels, opochs = 5) - 完成训练后,您将在最后一个时期结束时看到一个准确性值
acc。它可能看起来像0.8898。这告诉您,神经网络在对训练数据进行分类时的准确度约为89%。即,它找出了图像和标签之间的图案匹配,这些匹配在89%的时间内有效,效果不太好。但考虑到它只训练了5个epochs循环,并且很快就完成了,所以还不错。 - 但是如何处理未知的数据呢?这就是为什么我们有测试图像数据集
test set。我们可以调用model.evaluate,并传入测试数据集和标签,它将报告每个集合的损失。试一试吧: -
model.evaluate(test_images, test_labels) - 对我来说,返回的精度约为0.8716,这意味着它的精度约为87%。正如预期的那样,对于看不见的数据,它可能不如对经过训练的数据那样好.
- 使用模型预测功能
model.predict()打印出测试集数据的预测标签: -
classifications = model.predict(test_images) print(classification[0]) ## 打印测试集中第一张图的置信度列表 ## [3.5967298e-06 2.6537483e-09 2.9890811e-07 2.2175944e-07 2.5038032e-08 1.5626166e-03 7.2929214e-07 1.2695765e-02 2.5853420e-05 9.8571092e-01] 这里最后一个值最大,代表预测为第【9】个类别概率最大 ## 此列表代表什么?这是10个类别中每个类别的概率 print(test_labels[0]) ## 打印出测试集中第一张图的真实标签,(9) - 此列表代表什么?这是10个类别中每个类别的概率
使用512个神经元的全连接dense层进行实验,观察在损失loss和训练时间有什么不同?
import tenserflow as tf
print(__tf.version__)

mnist = tf.keras.satasets.fashion_mnist

(training_images,training_labels),(test_images, test_labels) = mnist.load_data()

training_images = training_images / 255.0 # 归一化
test_images = test_images / 255.0

model = tf.keras.models.Sequential([tf.keras.layers.Flatten(),
			tf.keras.layers.Dense(1024, activation=tf.nn.rule),
			tf.keras.layers.Dense(10, activation=tf.nn.softmax)])

model.compile(optimizer = 'adam',
		loss = 'sparse_categorical_crossentropy',
		metrics=['accuracy'])

model.fit(training_images, training_labels, epochs = 5)

model.evaluate(test_images, test_labels)

classifications = model.predict(test_images)

print(classification[0])
print(test_labels[0])
问题:增加到1024个神经元-有什么影响? 答案:训练需要更长的时间,但更准确(实际上由于数据集较简单准确性提高不是很多) 解析:通过添加更多的神经元,我们必须进行更多的计算,从而减慢该过程的速度,但是在这种情况下,它们会产生很好的影响-我们的确会变得更加准确。这并不意味着总是存在“越多越好”的情况!
问题:如果删除Flatten()层会发生什么。为什么? 答案:会得到有关数据形状的错误。 解析:现在看来似乎很模糊,但它加强了经验法则,即网络中的第一层应与数据的形状相同。现在,我们的数据是28x28的图像,而28层28个神经元将是不可行的,因此将28x28“展平”为784x1更有意义。在开始时添加Flatten()层,稍后将数组加载到模型中时,它们将自动为我们展平。
问题:最后的(输出)层为什么有十个呢?如果设置不等于10,会怎样? 答案:会出现错误。 解析:最后一层中的神经元数量应与您要分类的类的数量相匹配。在这种情况下,它是数字0-9,所以有10个数字,因此在最后一层中应该有10个神经元。
问题:如果在具有512和最后一层之间添加另一层,将会发生什么? 答案:没有重大影响-因为这是相对简单的数据。对于更复杂的数据(包括将在下一课中看到的分类为花朵的彩色图像),通常需要额外的图层。 解析:(在512和输出10之间增加了一层256个神经元),可以使用如下代码:
model = tf.keras.models.Sequential([tf.keras.layers.Flatten(),
		tf.keras.layers.Dense(512, activation=tf.nn.relu),
		tf.keras.layers.Dense(256, activation=tf.nn.relu),
		tf.keras.layers.Dense(10, activation=tf.nn.softmax)])
问题:训练循环次数epochs的影响? 答案:尝试15个epochs(你可能会在30个训练周期时得到一个比5个训练周期时更好的损失模型);或者你可能会看到损失值停止下降,有时会增加。这是所谓的“过度拟合”的副作用。如果没有改善自己的损失,浪费训练时间是没有意义的 :)在这个示例中,30个epochs并未过拟合,loss一直在下降,acc一直在上升。
问题:在训练之前,您已对数据进行了归一化,从0-255的值到0-1的值。删除它会产生什么影响?为什么您认为得到不同的结果? 答案:在此例中影响不大,但是在复杂数据集中,归一化有利于收敛,加快训练速度,提升训练准确性。
问题:早些时候,当你进行额外的训练循环时(如进行超过30的epochs),你会遇到损失可能会改变的问题。你可能需要花费一些时间来等待训练完成,并且你可能认为“如果我在达到期望值时停止训练,那不是很好吗?”-即90%的准确度可能对您来说足够了,如果在3个纪元后达到这一精度,为什么还要坐在那里等待它完成更多纪元….那么你将如何解决呢?像其他程序一样,你也可以使用callback回调: 答案:
import tenserflow as tf
print(tf.__version__)

class myCallback(tf.keras.callbacks.Callback):
	def on_epoch_end(self, epoch, logs={}):
		if(logs.get('acc')>0.9):
			print('\n Reached 90% accuracy so calling training!')
			self.model.stop_training = True

callbacks = myCallback()
mnist = tf.keras.datasets.fashion_mnist
(training_images, training_labels),(test_images, test_labels) = mnist.load_data()
training_images = training_images / 255.0
test_images = test_images / 255.0
model = tf.keras.models.Sequential([tf.karas.layers.Flatten(),
				tf.keras.layers.Dense(512, activation=tf.nn.relu),
				tf.keras.layers.Dense(10, activation=tf.softmax)])
model.compile(optimizer='adam', loss='sparse_categorical_crossentropy', metrics=['accuracy'])
model.fit(training_images, training_labels, epochs=50, callbacks=[callbacks]) # 这里设置epochs=50,实际在epoch=6时就达到设定的acc=0.9,停止训练了。
训练代码
# 导入必要的包
import tensorflow as tf
from tensorflow import keras

# 载入数据集,keras自带的fashion_mnist
fashion_mnist = keras.datasets.fashion_mnist

# 按格式导入train_images, train_labels, test_images, test_labels
(train_images, train_labels), (test_images, test_labels) = fashion_mnist.load_data()
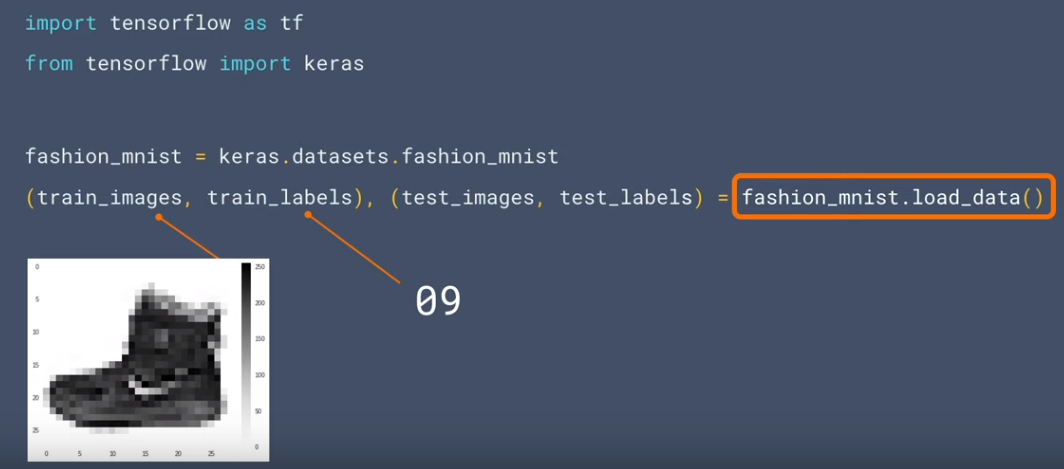
# 建立训练序列(Sequential)模型,输入input_shape为28×28;输入层与隐藏层为全连接Dense,隐藏层有128个神经元,(激励函数,线性整流函数)激活函数为relu函数进行非线性输出;隐藏层到输出层为全连接Dense,输出层有10个神经元,激活函数为softmax函数进行输出10个中的最大值对应的标签项(可能为独热编码,最大项设为1其他设为0)。
model = keras.Sequential([
	keras.layers.Flatten(input_shape=(28, 28)),
	keras.layers.Dense(128, activation=tf.nn.rule),
	keras.layers.Dense(10, activation=tf.nn.softmax)
])

# 优化函数和损失函数,神经网络初始使用随机数值,用损失函数测量结果好坏,优化器生成新的参数,输入到函数,看是否能得到更好的结果。
model.compile(optimizer=tf.train.AdamOptimizer(),
	loss='sparse_categorical_crossentropyy')
# 训练,只需要把训练图像拟合成标签就可以。指定训练时期epochs
model.fit(train_images, train_labels, epochs=5)
# 测试,把测试图片和测试标签传入
test_loss ,test_acc = model.evaluate(test_images, test_labels)
# 调用model.predict()方法,获取预测结果
predictions = model.predict(my_images)
第三节:卷积神经网络
(利用“过滤器”卷积,进行一些特征提取,之后在进行深度学习,这样你的网络就可以通过特征而不是像素进行学习了) 了解图像卷积和池化的概念:池化会压缩图像,从而进一步增强特征。
前面深度神经网络(DNN)的局限性
在上章节中,了解了如何使用Fashion MNIST数据集训练时尚商品的图像分类器。这虽然提供了一个比较准确的分类器,但是存在一个明显的限制:图像为28x28,灰度,并且项目位于图像的中心。
例如,这是Fashion MNIST中的几个图像:
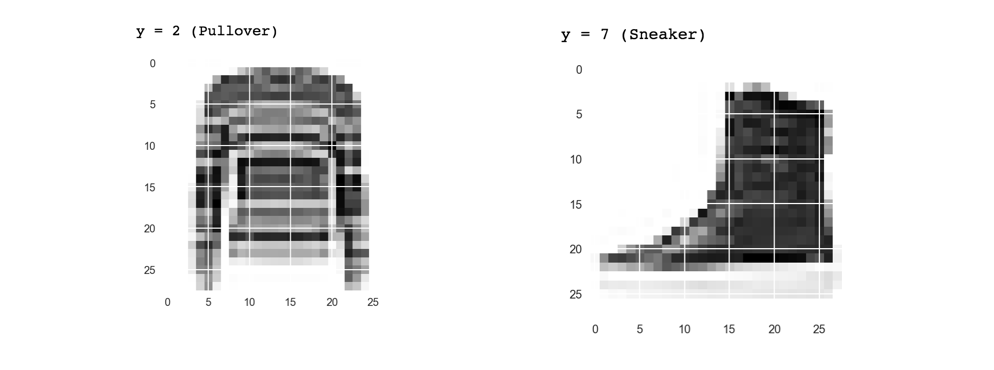 你创建的DNN只是从原始像素中了解了什么构成了一件毛衣,以及什么构成了一件靴子。但是,考虑如何对图像进行分类?
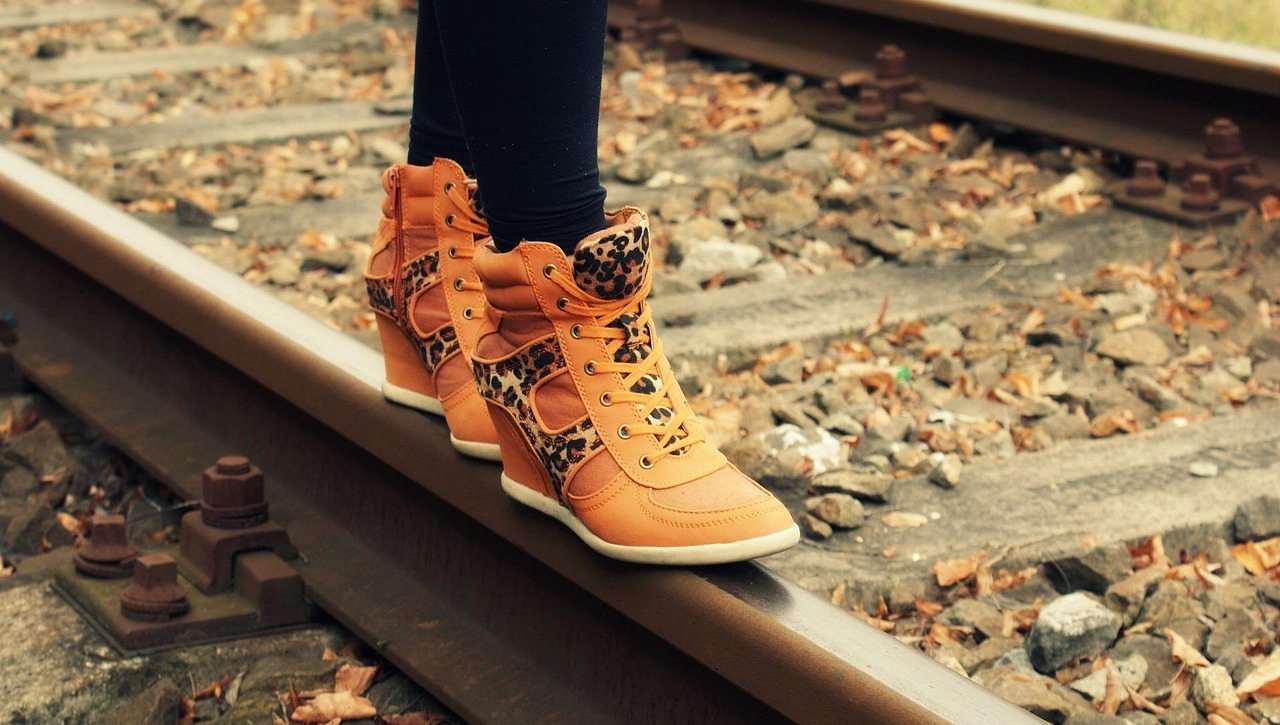 虽然很明显上面的图像是一双靴子,但是分类器由于多种原因而失败。首先,当然不是28x28灰度,而是更重要的是,分类器是针对左侧靴子的原始像素而不是组成靴子的功能进行训练的。
这就是卷积非常强大的地方。卷积是一种通过图像的过滤器,对其进行处理,然后提取出显示图像通用性的特征。在本实验中,你将看到它们的工作原理,通过处理图像以查看是否可以从中提取特征!
生成卷积非常简单-您只需扫描图像中的每个像素,然后查看它的相邻像素。您可以将这些像素的值乘以过滤器中的等效权重。例如:
 在这个示例中,将指定3x3卷积。当前像素值为192,但是您可以通过查看相邻像素值并将它们乘以过滤器中指定的值,然后将新像素值设为最终值来计算新的像素值。
让我们通过在2D灰度图像上创建基本卷积来探索卷积如何工作。首先,我们可以通过从scipy获取“ascent”图像来加载图像。这是一张漂亮的内置图片,其中包含许多角度和线条。
首先导入一些python库:
import cv2
import numpy as np
from scipy import misc
i = misc.ascent()
接下来我们利用pyplot库来绘制出图像:
import matplotlib.pyplot as plt
plt.grid(Flase)
plt.gray()
plt.axis('off')
plt.imshow(i)
plt.show()
显示图像为:
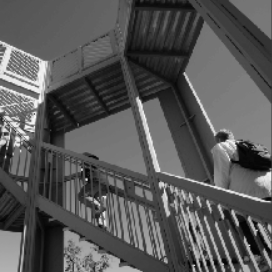
可以看到这是楼梯间的图像。 这里有很多特征可供我们查看是否可以分析它们-例如,有很强的垂直线。 该图像存储为一个numpy数组,因此我们只需复制该数组即可创建转换后的图像。我们还要获取图像的尺寸,以便稍后进行循环。
i_transformed = np.copy(i)
size_x = i_transformed.shape[0]
size_y = i_transformed.shape[1]
接下来创建一个3X3数组的过滤器
# this filter detects edges nicely
# It creates a cconvolution that only passes through sharp edges and straight lines.

# Experiment with different values for fun effects.
# filter = [ [0, 1, 0], [1, -4, 1], [0, 1, 0]]

# A couple more filters to try for fun!
filter = [ [-1, -2, -1], [0, 0, 0], [1, 2, 1]]
# filter = [ [-1, 0, 1], [-2, 0, 2], [-1, 0, 1]]

# If all the digits in the filter don't add up to 0 or 1, you
# should probably do a weight to get it to do so
# so, for example, if your weights are 1,1,1 1,2,1 1,1,1
# They add up to 10, so you would set a weight of .1 if you want to normalize them
weight  = 1
现在让我们创建一个卷积。我们将遍历图像,保留1个像素的空白,然后将当前像素的每个相邻像素乘以滤镜中定义的值。 也就是说,当前像素在其上方和左侧的邻居将与滤镜中的左上角项目等相乘。然后将结果乘以权重,然后确保结果在0-255范围内最后,我们将新值加载到转换后的图像中。
for x in range(1,size_x-1):
  for y in range(1,size_y-1):
      convolution = 0.0
      convolution = convolution + (i[x - 1, y-1] * filter[0][0])
      convolution = convolution + (i[x, y-1] * filter[0][1])
      convolution = convolution + (i[x + 1, y-1] * filter[0][2])
      convolution = convolution + (i[x-1, y] * filter[1][0])
      convolution = convolution + (i[x, y] * filter[1][1])
      convolution = convolution + (i[x+1, y] * filter[1][2])
      convolution = convolution + (i[x-1, y+1] * filter[2][0])
      convolution = convolution + (i[x, y+1] * filter[2][1])
      convolution = convolution + (i[x+1, y+1] * filter[2][2])
      convolution = convolution * weight
      if(convolution<0):
        convolution=0
      if(convolution>255):
        convolution=255
      i_transformed[x, y] = convolution
接下来我们可以使用pyplot绘制卷积之后的图像:
# Plot the image. Note the size of the axes -- they are 215 x 512
plt.gray()
plt.grid(Flase)
plt.imshow(i_transformed)
# plt.axis('off')
plt.show()
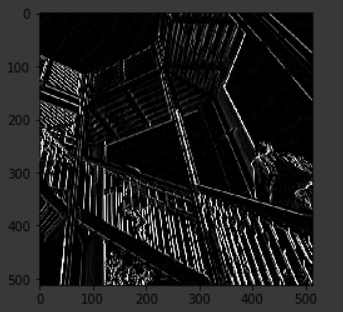
考虑以过滤器的值对图像的影响。
使用-1,0,1,-2,0,2,-1,0,1为我们提供了非常明显的垂直线:

使用-1,-2,-1、0、0、0、1、2、1可得出水平线:

池化
除了使用卷积,池化可以极大地帮助我们检测特征。目的是减少图像中的信息总量,同时保持所检测到的特征存在。
有许多不同类型的池化,但是在本实验中,我们将使用一种称为MAX pooling的池化。
这里的想法是遍历图像,并查看像素,它是右侧,下方和右侧的直接邻居。选取其中最大的一个(因此名称为MAX pooling)并将其加载到新图像中。因此,新图像的大小将是旧图像的1/4-通过此过程,X和Y的尺寸都将减半。您会发现尽管进行了压缩,这些特征都得以维护!
 下面的代码将显示(2,2)的池化,运行它以查看输出,您将看到虽然图像是原始图像大小的1/4,但提取的特征得以保留!
new_x = int(size_x/2)
new_y = int(size_y/2)
newImages = np.zeros((new_x, new_y))
for x in range(0, size_x, 2):
	for y in range(0,size_y, 2):
	pixels = []
	pixels.append(i_transformed[x, y])
	pixels.append(i_transformed[x+1, y])
	pixels.append(i_transformed[x, y+1])
	pixels.append(i_transformed[x+1, y+1])
	pixels.sort(reverse=True)
	newImage[int(x/2), int(y/2)] = pixels[0] # 最大值

# Plot the images. Note the size of the axes -- now 256 pixels instead 512
plt.gray()
plt.grid(Flase)
plt.imshow(newImage)
# plt.axis('off')
plt.show()
在下一个实验中,你将看到如何向fashion MNIST神经网络添加卷积以使其更加高效-因为它将基于特征而不是原始像素进行分类。
第四节:使用卷积提高计算机视觉精度
在前面的练习中,你了解了如何使用包含三层的深度神经网络(DNN)进行fashion mnist数据集识别-输入层(以数据的形式),输出层(以所需的输出的形式)和隐藏层。也尝试了不同大小的隐藏层,训练时期数等对最终精度的影响。为了方便起见,这里再次是整个代码。运行它,并记下最后打印出的测试精度。
import tenserflow as tf
mnist = tf.keras.datasets.fashion_mnist
(training_images, training_labels),(test_images, test_labels)=mnist.load_data()
training_images = training_images/255.0
test_images = test_images /255.0
model = tf.keras.models.Sequential([
					tf.keras.layers.Flatten(),
					tf.keras.layers.Dense(128, activation=tf.nn.relu),
					tf.keras.layers.Dense(10, activation=tf.nn.softmax)
					])
model.compile(optimizer='adam',loss='sparse_categorical_crossentropy, metrics=['accuracy'])
model.fit(training_images, training_labels, epochs=5)

test_loss=model.evaluate(test_images, test_labels)
你在训练中的准确性可能约为89%,在验证中的准确性为87%…还不错…但是您如何使它变得更好呢?一种方法是使用称为卷积的东西。我在这里不打算详细介绍卷积,但最终的概念是它们缩小了图像的内容,以专注于特定的,独特的细节。 如果您曾经使用过滤器(例如:https://en.wikipedia.org/wiki/Kernel_(image_processing) 进行图像处理,那么卷积将非常熟悉。 简而言之,你可以使用一个数组(通常为3x3或5x5)并将其传递到图像上。通过基于该矩阵内的公式更改基础像素,可以执行诸如边缘检测之类的操作。因此,例如,如果你查看上面的wiki链接,会看到为边缘检测定义的3x3,中间单元格为8,其所有邻居均为-1。在这种情况下,对于每个像素,你可以将其值乘以8,然后减去每个相邻像素的值。对每个像素执行此操作,将得到一个具有增强边缘的新图像。 这对于计算机视觉来说是完美的,因为通常可以像这样突出显示的功能将一项与另一项区分开,因此所需的信息量就少得多了……因为你只是在突出显示的功能上进行训练。那就是卷积神经网络的概念。在具有密集层(dense layer)之前,添加一些层进行卷积,然后进入密集层(dense layer)的信息将更加集中,甚至可能更准确。
运行以下代码:这与之前的神经网络相同,但是这次添加了卷积层。这将花费更长的时间,但注意观察对准确性的影响:
import tenserflow as tf
print(tf.__version__)

mnist = tf.keras.datasets.fashion_mnist
(training_images, training_labels),(test_images, test_labels)=mnist.load_data()
training_images = training_images.reshape(60000,28,28,1)
training_images = training_images / 255.0
test_images = test_images.reshape(10000,28,28,1)
test_images = test_images / 255.0
model = tf.keras.models.Sequnential([
	tf.keras.layers.Conv2D(64,(3,3),activation='relu',input_shape(28,28,1)),
	tf.keras.layers.MaxPooling2D(2,2)
	tf.keras,layers.Conv2D(64,(3,3),activation='relu'),
	tf.keras.layers.MaxPooling2D(2,2)
	tf.keras.layers.Flatten(),
	tf.keras.layers.Dense(128, activation='relu'),
	tf.keras.layers.Dense(10, activation='softmax')
])
model.compile(optimizer='adam', loss='sparse_categorical_crossentropy',metrics=['accuracy'])
model.summary()
model.fit(training_images,training_labels,epochs=5)
test_loss=model.evaluate(test_images,test_labels)
训练数据和验证数据的比例可能上升到约93%。这很重要,而且朝着正确的方向迈出了一步!尝试运行它以获取更多的时期epochs-据说大约20个epochs果!但是,尽管结果看起来确实不错,但由于称为“过度拟合”的问题,验证结果实际上可能会下降,这将在后面讨论。(简而言之,当网络从训练集中很好地学习数据时,就会发生“过度拟合”,但是它过于专业化,无法仅对这些数据进行学习,因此在查看其他数据时效率较低。例如:比如你一生都在学习您只看到红色的鞋子,那么当你看到红色的鞋子时,会很擅长识别它,但是蓝色的绒面革鞋子可能会使你感到困惑……)。
再次查看代码,逐步了解卷积的构建方式: 第一步:是收集数据。你会注意到这里有些变化,需要重新调整训练数据。那是因为第一个卷积希望一个包含所有内容的张量,这里我们使用了一个60000x28x28x1的4维度列表,而没有使用的60000个28x28x1的列表,对于测试图像而言也是相同的。如果不这样做,则在训练时会出现错误,因为卷积无法识别形状。
import tenserflow as tf
mnist = tf.keras.datasets.fashion_mnist
(training_images,training_labels),(test_images,test_labels)=mnist.load_data()
training_images=training_images.reshape(60000,28,28,1)
training_iamges = training_images / 255.0
test_images=test_images.reshape(10000,28,28,1)
test_images = test_images / 255.0
第2步:定义你的训练模型。现在,你将添加卷积,而不是顶部的输入层。参数为:
- 要生成的卷积数。卷积的数量纯粹是任意的,但最好从32左右开始。
- 卷积的大小,在这里为3x3网格。
- 要使用的激活函数-在这里,我们将使用relu,(它相当于x> 0时返回x,否则返回0。)
- 在第一层中,输入数据的形状。
你将在卷积后面跟随一个MaxPooling层,该层然后被设计为压缩图像,同时保持被卷积突出显示的特征的内容。通过为(MaxPooling)指定(2,2),效果是将图像大小缩小四分之一。此处无需赘述,其思想是创建一个2x2像素阵列,并选择最大的像素阵列,从而将4个像素变为1。它在整个图像中重复进行此操作,从而将水平数量减少了一半,并将垂直像素的数量减半,有效地将图像缩小到25%。
你可以调用model.summary()来查看网络的大小和形状,并且你会注意到,在每个MaxPooling层之后,图像大小都会以这种方式减小。
model = tf.keras.models.Sequential([
  tf.keras.layers.Conv2D(32, (3,3), activation='relu', input_shape=(28, 28, 1)),
  tf.keras.layers.MaxPooling2D(2, 2),
添加另一个卷积:
  tf.keras.layers.Conv2D(64, (3,3), activation='relu'),
  tf.keras.layers.MaxPooling2D(2,2)
现在将卷积和池化的输出展平。之后,你将获得与非卷积版本相同的DNN结构
tf.keras.layers.Flatten()
与卷积前示例相同,共有128个密集层和10个输出层:
  tf.keras.layers.Dense(128, activation='relu'),
  tf.keras.layers.Dense(10, activation='softmax')
])
现在编译模型,调用fit方法进行训练,并从测试集中评估损失和准确性。
model.compile(optimizer='adam', loss='sparse_categorical_crossentropy', metrics=['accuracy'])
model.fit(training_images, training_labels, epochs=5)
test_loss, test_acc = model.evaluate(test_images, test_labels)
print(test_acc)
卷积和池化的可视化
这段代码将以图形方式向我们展示卷积。print(test_labels [; 100])向我们显示了测试集中的前100个标签,你可以看到索引0,索引23和索引28的标签都具有相同的值(9)。他们都是鞋子。让我们看一下在每个卷积上进行卷积的结果,你将开始看到它们之间出现了共同的特征。现在,当DNN对该数据进行训练时,它的工作量大大减少了,并且可能基于这种卷积/池化的组合在鞋子之间找到了共同点。
print(test_labels[;100])
import matplotlib.pyplot as plt
f, axarr = plt.subplots(3,4)
FIRST_IMAGE=0
SECOND_IMAGE=7
THIRD_IMAGE=26
CONVOLUTION_NUMBER = 1
from tensorflow.keras import models
layer_outputs = [layer.output for layer in model.layers]
activation_model = tf.keras.models.Model(inputs = model.input, outputs = layer_outputs)
for x in range(0,4):
  f1 = activation_model.predict(test_images[FIRST_IMAGE].reshape(1, 28, 28, 1))[x]
  axarr[0,x].imshow(f1[0, : , :, CONVOLUTION_NUMBER], cmap='inferno')
  axarr[0,x].grid(False)
  f2 = activation_model.predict(test_images[SECOND_IMAGE].reshape(1, 28, 28, 1))[x]
  axarr[1,x].imshow(f2[0, : , :, CONVOLUTION_NUMBER], cmap='inferno')
  axarr[1,x].grid(False)
  f3 = activation_model.predict(test_images[THIRD_IMAGE].reshape(1, 28, 28, 1))[x]
  axarr[2,x].imshow(f3[0, : , :, CONVOLUTION_NUMBER], cmap='inferno')
  axarr[2,x].grid(False)
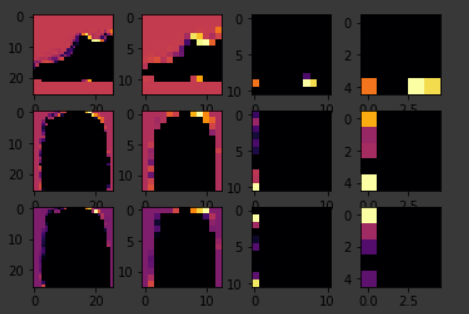
练习
- 尝试修改卷积数量。将32更改为16或64。这将对准确性和/或训练时间产生什么影响。
- 删除最后的卷积。这将对准确性或培训时间产生什么影响?
- 如何添加更多卷积?这会产生什么影响?
- 尝试一下。除去所有卷积,但第一个除外。这会产生什么影响?
- 尝试一下。在上一课中,您实现了一个回调以检查损失功能并在达到一定量后取消训练。看看您是否可以在这里实现!
第五节:对复杂图像使用卷积
在之前的实验中,已经使用Fashion MNIST数据集训练图像分类器。在这种情况下,你所拍摄的图像是主体居中放置的28x28像素的图像。在本实验中,您将更进一步,进行训练以识别图像中的特征,其中对象可以位于图像中的任何位置! 你将通过建立一个马或人分类器来做到这一点,该分类器将告诉你,给定的图像是否包含马或人,其中训练了网络来识别确定哪个图像的特征。
对于Fashion MNIST,数据是通过Keras内置到TensorFlow中的。在这种情况下,不需要进行一些数据处理就可以进行训练。但是,其他数据集就不行了。首先,让我们下载数据:
!wget --no-check-certificate https://storage.googleapis.com/laurencemorone-blog.appspot.com/horse-or-human.zip -0 /tmp/horese-or-human.zip
以下python代码将使用OS库来使用操作系统库,从而使您可以访问文件系统,并使用zipfile库来解压缩数据。
import os
import zipfile

local_zip = '/tmp/horse-or-human.zip'
zip_ref = zipfile.ZipFile(local_zip,'r')
zip_ref.extractall('/tmp/horse-or-human')
zip_ref.close()
.zip的内容被解压到/tmp/horse-or-human,该目录又包含horses和humans的子目录。简而言之:训练集是用于告诉神经网络模型“这就是马的样子”,“这就是人的样子”等的数据。
此示例中要注意的一件事:我们没有将图像明确标记为马或人。如果您还记得前面的时装示例,我们将其标记为“这是1”,“这是7”等。
稍后,你会看到正在使用一种称为ImageGenerator的东西,它被编码为从子目录读取图像,并从该子目录的名称中自动标记它们。因此,例如,您将拥有一个“训练”目录,其中包含一个“horses”目录和一个“humans”目录。ImageGenerator将为您适当地标记图像,从而减少了编码步骤。
让我们定义以下每个目录:
# Directory with our training horse pictures
train_horse_dir = os.path.join('/tmp/horse-or-human/horses')

# Directory with our training human pictures
train_human_dir = os.path.join('/tmp/horse-or-human/humans')
现在,让我们看看horses和humans训练目录中的文件名是什么样的:(打印前10条)
train_horse_names = os.listdir(train_horse_dir)
print(train_horse_names[:10])

train_human_names = os.listdir(train_human_dir)
print(train_human_names[:10])
让我们找出目录中的马和人像总数:
print('total training horse images:', len(os.listdir(train_horse_dir)))
print('total training human images:', len(os.listdir(train_human_dir)))
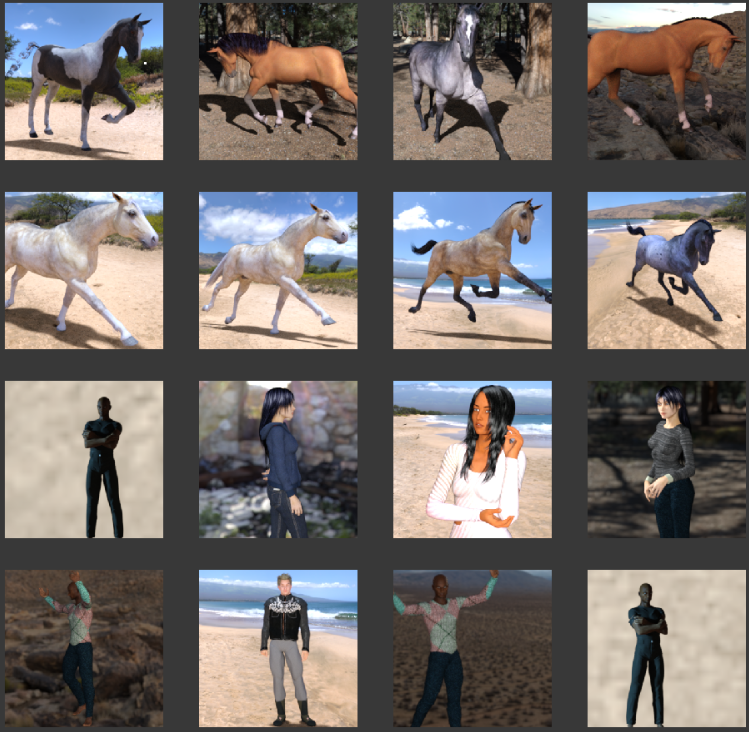
total training horse images: 500 total training human images: 527 现在,让我们看一小部分这些图片,以更好地了解它们的外观。首先,配置matplot参数:
import matplotlib.pyplot as plt
import matplotlib.image as mpimg

# Parameters for our graph; we'll output images in a 4x4 configuration
nrows = 4
ncols = 4

# Index for iterating over images
pic_index = 0
现在,显示一批8匹马和8幅人像。你可以每次重新运行单元以查看新批次:
# Set up matplotlib fig, and size it to fit 4x4 pics
fig = plt.gcf()
fig.set_size_inches(ncols * 4, nrows * 4)

pic_index += 8
next_horse_pix = [os.path.join(train_horse_dir, fname)
                for fname in train_horse_names[pic_index-8:pic_index]]
next_human_pix = [os.path.join(train_human_dir, fname)
                for fname in train_human_names[pic_index-8:pic_index]]

for i, img_path in enumerate(next_horse_pix+next_human_pix):
  # Set up subplot; subplot indices start at 1
  sp = plt.subplot(nrows, ncols, i + 1)
  sp.axis('Off') # Don't show axes (or gridlines)

  img = mpimg.imread(img_path)
  plt.imshow(img)

plt.show()
从头开始构建小型模型
但是在继续之前,让我们开始定义模型: 步骤1将是导入tensorflow。
import tenserflow as tf
然后,像前面的示例一样,添加卷积层,并将最终结果展平以馈入Dense密集连接的层。 最后,我们添加密集连接的层。 请注意,由于我们面临两类分类问题,即二进制分类问题,因此我们将以S形激活来结束网络,以便网络的输出将是介于0和1之间的单个标量,从而编码当前图像是1类(而不是0类)。
model = tf.keras.models.Sequential([
	# Note the input shape is the desired size of the image 300x300 with 3 bytes color

    # This is the first convolution
    tf.keras.layers.Conv2D(16,(3,3),activation='relu',input_shape=(300,300,3)),
    tf.keras.layers.MaxPooling2D(2,2),
    # The second convolution layer
    tf.keras.layers.Conv2D(32,(3,3),activation='relu'),
    tf.keras.layers.MaxPooling2D(2,2),
    # The third convolution layer
    tf.keras.layers.Conv2D(64,(3,3),activation='relu'),
    tf.keras.layers.MaxPooling2D(2,2),
    tf.keras.layers.Conv2D(64,(3,3),activation='relu'),
    tf.keras.layers.MaxPooling2D(2,2),
    # Flatten the results to feed into a DNN
    tf.keras.layers.Flatten(),
    # 512 neuron hidden layer
    tf.keras.layers.Dense(512,activation='relu'),
    # Only 1 out neuron. It will contain a value from 0-1 where 0 for class('horses') and 1 for the other ('humans')
    tf.keras.layers.Dense(1,activation='sigmoid')
])
model.summary()方法调用将打印神经网络的摘要
model.summary()
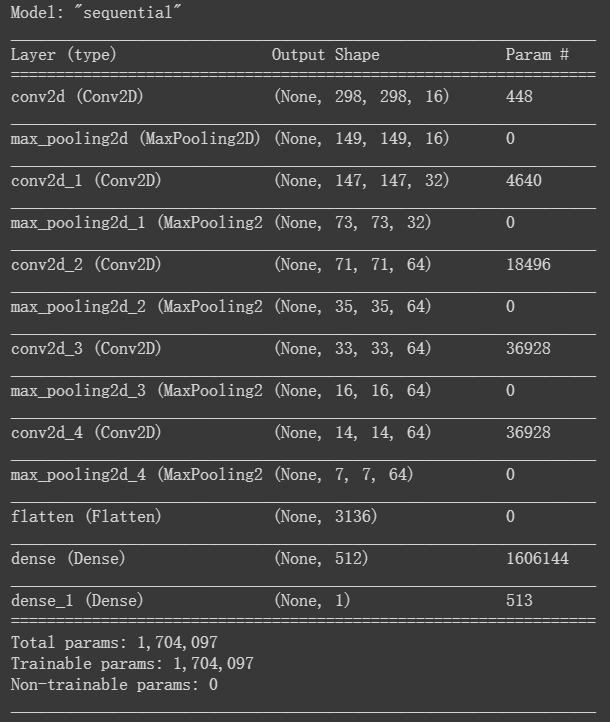
“输出形状”列显示了feature map的大小在每个连续的图层中如何演变。卷积层由于填充而使特征图的大小略微减少,每个池化层将尺寸减半。
接下来,我们将配置模型训练的规范。我们将使用binary_crossentropy损失训练模型,因为这是一个二进制分类问题,而我们的最终激活函数是sigmoid。(有关损失矩阵的更新,请参阅机器学习速成课程。)我们将使用rmsprop优化器,其学习率为0.001。在训练期间,我们将要监控分类的准确性。
注意:在这种情况下,使用RMSprop优化算法要优于随机梯度下降(SGD),因为RMSprop可以自动为我们调整学习速率。(其他优化器,例如Adam和Adagrad,也可以在训练过程中自动调整学习率,并且在此处同样适用。)
from tenserflow.keras.optimizer import RMSprop

model.compile(loss='binary_crossentropy',optimizer=RMSprop(lr=0.001),metrics=['acc'])
数据预处理
让我们设置数据生成器,该数据生成器将读取源文件夹中的图片,将其转换为float32张量,并将它们(带有标签)送到我们的网络中。我们将为训练图像提供一个生成器,为验证图像提供一个生成器。我们的生成器将生成一批尺寸为300x300的图像及其标签(二进制)。
你可能已经知道,进入神经网络的数据通常应该以某种方式进行规范化,以使其更适合网络处理。(将原始像素输入到卷积图中是很罕见的。)在本例中,我们将通过将像素值标准化为[0,1]范围(最初所有值都在[0,255]范围内)来预处理图像)。
在Keras中,这可以通过keras.preprocessing.image.ImageDataGenerator类使用rescale参数来完成。使用此ImageDataGenerator类,您可以通过.flow(data,labels)或.flow_from_directory(directory)实例化增强图像批处理(及其标签)的生成器。然后,这些生成器可以与Keras模型方法一起使用,这些方法将数据生成器作为输入:fit_generator,evaluate_generator和predict_generator。
from tenserflow.keras.preprocessing.image import ImageDataGenerator

# All images will be rescaled by 1./255
train_datagen = ImagesDataGenerator(rescale=1/255)

# train_generator = train_datagen.flow_from_directory(
	'/tmp/horse-or-human/',    # This is the source directory for training images
	target_size = (300,300),   # All images will be resized to 300x300
	batch_size = 128,
	# sice we use binary_crossentropy loss,we need binary labels
	class_mode = 'binary')
训练
让我们训练15个epochs-可能要花几分钟的时间。 请注意每个时期的值。损失和准确性是训练进度的重要标志。它正在猜测训练数据的分类,然后根据已知标签对其进行测量,然后计算结果。准确性是正确猜测的一部分。
history = model.fit_generator(
		train_generator,
		step_per_epoch=8,
		epochs=15,
		verbose=1)
运行模型
现在让我们看一下使用模型实际运行预测。此代码将允许你从文件系统中选择1个或多个文件,然后将其上传并在模型中运行它们,从而指示对象是马还是人。你也可以将图像从Internet下载到文件系统中进行尝试! 请注意,尽管训练准确性超过99%,仍可能会看到网络犯了很多错误。这是由于所谓的过拟合导致的,这意味着使用非常有限的数据来训练神经网络,每个类别只有500张图像。因此,它在识别训练集中的图像表现很好,但是对于不在训练集中的图像可能不够好。 这是一个数据点,证明您训练的数据越多,最终的网络就越好! 尽管数据有限,但是有许多技术可以用来使您的训练更好,包括称为“图像增强”的东西。那超出了本实验的范围!
import numpy as np
from google.colab import files
from keras.preprocessing import image

uploaded = files.upload()

for fn in upload.keys():

	# predicting images
	path = '/content/'+fn
	img = image.load_img(path, target_size=(300,300))
	x = image.img_to_array(img)
	x = np.expend_dims(x, axis=0)

	images = np.vstack([x])
	classes = model.predict(images, batch_size=10)
	print(classes[0])
	if classes[0]>0.5:
		print(fn+'is a human')
	else:
		print(fn+'is a horse')
第六节:可视化中间表示
为了感觉一下我们的卷积网络学习了哪些功能,要做的一件有趣的事情是可视化输入在卷积网络中的转换。 让我们从训练集中选择一个随机图像,然后生成一个图形,其中每一行都是图层的输出,而行中的每一幅图像都是该输出要素图中的特定过滤器。重新运行此单元格以生成各种训练图像的中间表示。
import numpy as np
import random
from tensorflow.keras.preprocessing.image import img_to_array, load_img

# Let's define a new Model that will take an image as input, and will output
# intermediate representations for all layers in the previous model after
# the first.
successive_outputs = [layer.output for layer in model.layers[1:]]
#visualization_model = Model(img_input, successive_outputs)
visualization_model = tf.keras.models.Model(inputs = model.input, outputs = successive_outputs)
# Let's prepare a random input image from the training set.
horse_img_files = [os.path.join(train_horse_dir, f) for f in train_horse_names]
human_img_files = [os.path.join(train_human_dir, f) for f in train_human_names]
img_path = random.choice(horse_img_files + human_img_files)

img = load_img(img_path, target_size=(300, 300))  # this is a PIL image
x = img_to_array(img)  # Numpy array with shape (150, 150, 3)
x = x.reshape((1,) + x.shape)  # Numpy array with shape (1, 150, 150, 3)

# Rescale by 1/255
x /= 255

# Let's run our image through our network, thus obtaining all
# intermediate representations for this image.
successive_feature_maps = visualization_model.predict(x)

# These are the names of the layers, so can have them as part of our plot
layer_names = [layer.name for layer in model.layers]

# Now let's display our representations
for layer_name, feature_map in zip(layer_names, successive_feature_maps):
  if len(feature_map.shape) == 4:
    # Just do this for the conv / maxpool layers, not the fully-connected layers
    n_features = feature_map.shape[-1]  # number of features in feature map
    # The feature map has shape (1, size, size, n_features)
    size = feature_map.shape[1]
    # We will tile our images in this matrix
    display_grid = np.zeros((size, size * n_features))
    for i in range(n_features):
      # Postprocess the feature to make it visually palatable
      x = feature_map[0, :, :, i]
      x -= x.mean()
      x /= x.std()
      x *= 64
      x += 128
      x = np.clip(x, 0, 255).astype('uint8')
      # We'll tile each filter into this big horizontal grid
      display_grid[:, i * size : (i + 1) * size] = x
    # Display the grid
    scale = 20. / n_features
    plt.figure(figsize=(scale * n_features, scale))
    plt.title(layer_name)
    plt.grid(False)
    plt.imshow(display_grid, aspect='auto', cmap='viridis')
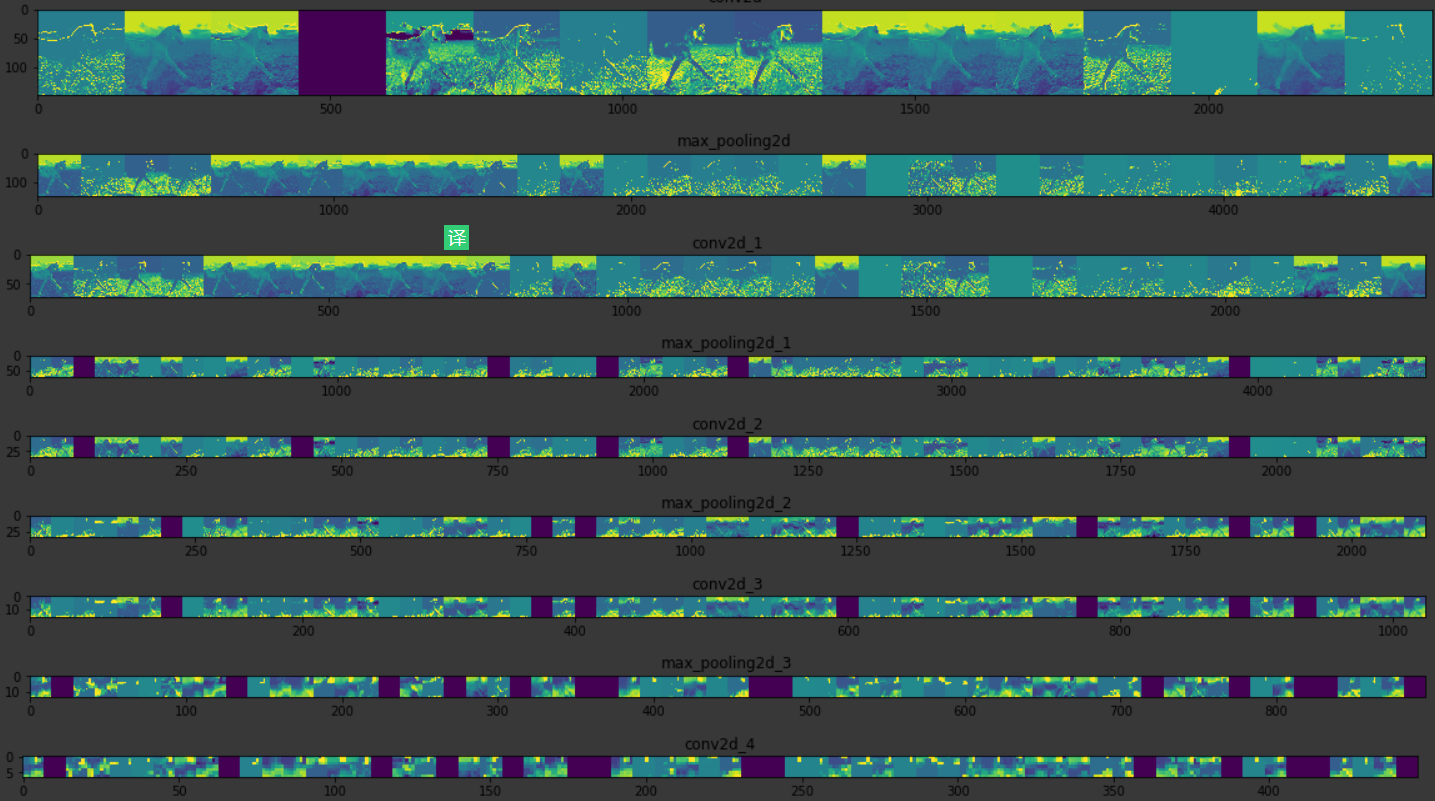
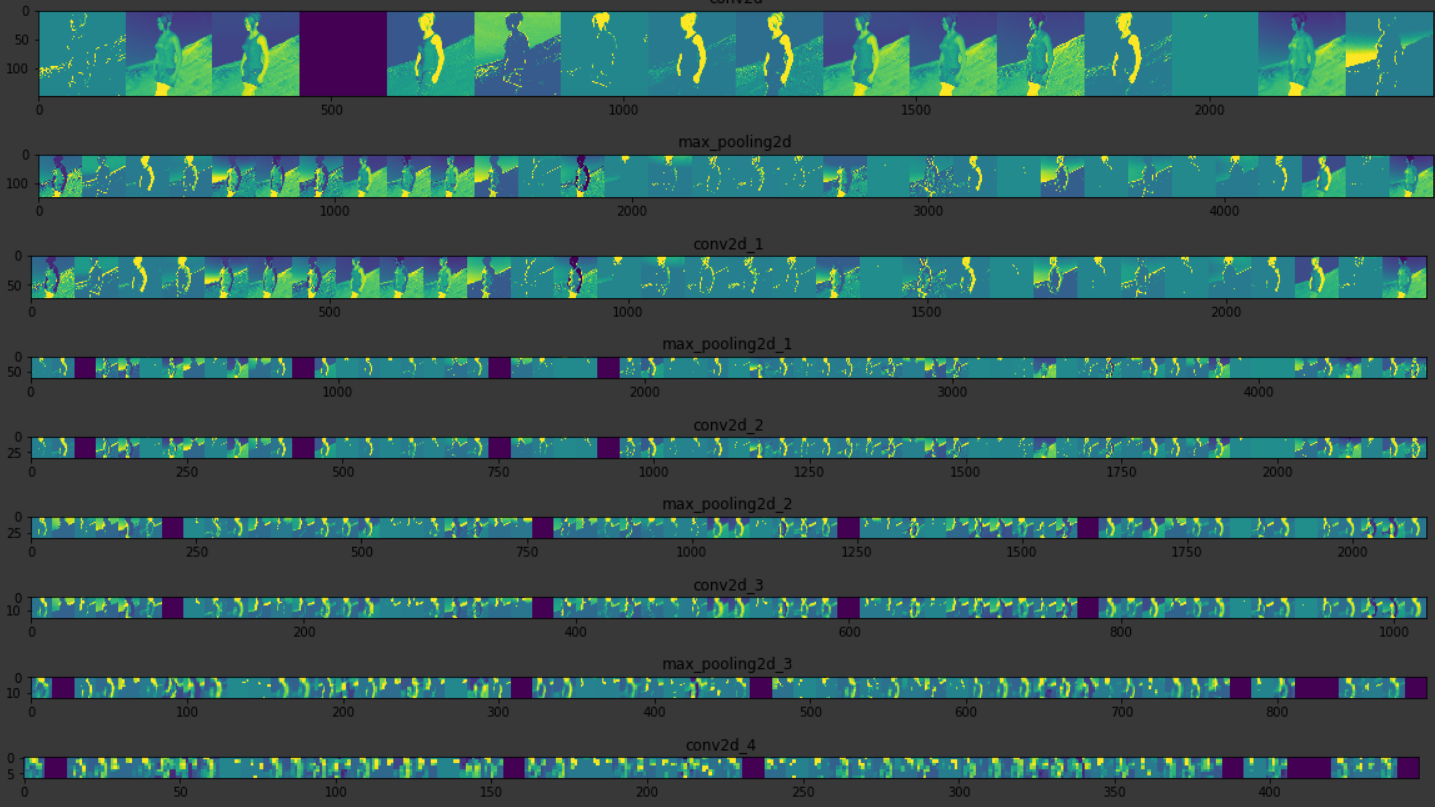 如你所见,我们从图像的原始像素过渡到越来越抽象和紧凑的表示形式。下游的表示开始突出显示网络要注意的内容,并且显示“激活”的功能越来越少。大多数设置为零。这称为“稀疏”。表示稀疏性是深度学习的关键特征。
这些表示所携带的关于图像原始像素的信息越来越少,但是携带的有关图像类别的信息却越来越精细。您可以将卷积网络(或通常称为深层网络)视为信息蒸馏管道。
清理
在运行下一个练习之前,请运行以下单元格以终止内核并释放内存资源:
import os, signal
os.kill(os.getpid(), signal.SIGKILL)