机器学习
[简] 什么是(监督式)机器学习?
机器学习系统,通过学习如何组合输入信息,来对从未见过的数据 做出有用的预测
术语:样本和模型
- 样本:是指数据的特定实例:x
- 特征:是表示数据的方式
- 有标签样本具有{特征,标签}:(x,y)
- 用于训练模型
- 无标签样本具有{特征,?}:(x,?)
- 用于对新数据做出预测
- 模型可将样本映射到预测标签:y ‘
- 由模型的内部参数定义,这些内部参数值是通过学习得到的
[详] 机器学习主要术语
什么是(监督式)机器学习?简单来说,它的定义如下:
- 机器学习系统通过学习如何组合输入信息来对从未见过的数据做出有用的预测。
下面我们来了解一下机器学习的基本术语。
标签
标签是我们要预测的事物,即简单线性回归中的 y 变量。标签可以是小麦未来的价格、图片中显示的动物品种、音频剪辑的含义或任何事物。
特征
特征是输入变量,即简单线性回归中的 x 变量。简单的机器学习项目可能会使用单个特征,而比较复杂的机器学习项目可能会使用数百万个特征,按如下方式指定:
\(\\{x_1, x_2, ... x_N\\}\)
在垃圾邮件检测器示例中,特征可能包括:
- 电子邮件文本中的字词
- 发件人的地址
- 发送电子邮件的时段
- 电子邮件中包含“一种奇怪的把戏”这样的短语。
样本
样本是指数据的特定实例:x。(我们采用粗体 x 表示它是一个矢量。)我们将样本分为以下两类:
- 有标签样本
- 无标签样本
有标签样本同时包含特征和标签。即:
labeled examples: {features, label}: (x, y)
我们使用有标签样本来训练模型。在我们的垃圾邮件检测器示例中,有标签样本是用户明确标记为“垃圾邮件”或“非垃圾邮件”的各个电子邮件。
例如,下表显示了从包含加利福尼亚州房价信息的数据集中抽取的 5 个有标签样本:
| housingMedianAge(特征) | totalRooms(特征) | totalBedrooms(特征) | medianHouseValue(标签) |
|---|---|---|---|
| 15 | 5612 | 1283 | 66900 |
| 19 | 7650 | 1901 | 80100 |
| 17 | 720 | 174 | 85700 |
| 14 | 1501 | 337 | 73400 |
| 20 | 1454 | 326 | 65500 |
无标签样本包含特征,但不包含标签。即:
unlabeled examples: {features, ?}: (x, ?)
以下是取自同一住房数据集的 3 个无标签样本,其中不包含 medianHouseValue:
| housingMedianAge(特征) | totalRooms(特征) | totalBedrooms(特征) |
|---|---|---|
| 42 | 1686 | 361 |
| 34 | 1226 | 180 |
| 33 | 1077 | 271 |
在使用有标签样本训练模型之后,我们会使用该模型预测无标签样本的标签。在垃圾邮件检测器示例中,无标签样本是用户尚未添加标签的新电子邮件。
模型
模型定义了特征与标签之间的关系。例如,垃圾邮件检测模型可能会将某些特征与“垃圾邮件”紧密联系起来。我们来重点介绍一下模型生命周期的两个阶段:
-
训练是指创建或学习模型。也就是说,向模型展示有标签样本,让模型逐渐学习特征与标签之间的关系。
-
推断是指将训练后的模型应用于无标签样本。也就是说,使用经过训练的模型做出有用的预测 (
y')。例如,在推断期间,您可以针对新的无标签样本预测medianHouseValue。
回归与分类
回归模型可预测连续值。例如,回归模型做出的预测可回答如下问题:
-
加利福尼亚州一栋房产的价值是多少?
-
用户点击此广告的概率是多少?
分类模型可预测离散值。例如,分类模型做出的预测可回答如下问题:
- 某个指定电子邮件是垃圾邮件还是非垃圾邮件?
- 这是一张狗、猫还是仓鼠图片?
练习
- 1、假设您想开发一种监督式机器学习模型来预测指定的电子邮件是“垃圾邮件”还是“非垃圾邮件”。以下哪些表述正确?
- 有些标签可能不可靠。
- 未标记为“垃圾邮件”或“非垃圾邮件”的电子邮件是无标签样本。
- 主题标头中的字词适合做标签。
- 我们将使用无标签样本来训练模型。
解析:正确答案:1、2;有些标签可能不可靠。当然。此数据集的标签可能来自将特定电子邮件标记为垃圾邮件的电子邮件用户。由于很少的用户会将每一封可疑的电子邮件都标记为垃圾邮件,因此我们可能很难知道某封电子邮件是否是垃圾邮件。此外,有些垃圾内容发布者或僵尸网络可能会故意提供错误标签来误导我们的模型。未标记为“垃圾邮件”或“非垃圾邮件”的电子邮件是无标签样本。由于我们的标签由“垃圾邮件”和“非垃圾邮件”这两个值组成,因此任何尚未标记为垃圾邮件或非垃圾邮件的电子邮件都是无标签样本。主题标头中的字词可能是优质特征,但不适合做标签。我们将使用有标签样本来训练模型。然后,我们可以对无标签样本运行训练后的模型,以推理无标签的电子邮件是垃圾邮件还是非垃圾邮件。
- 2、假设一家在线鞋店希望创建一种监督式机器学习模型,以便为用户提供合乎个人需求的鞋子推荐。也就是说,该模型会向小马推荐某些鞋子,而向小美推荐另外一些鞋子。以下哪些表述正确?
- “用户点击鞋子描述”是一项实用标签。
- 鞋码是一项实用特征。
- 鞋的美观程度是一项实用特征。
- 用户喜欢的鞋子是一种实用标签。
解析:正确答案:1、2;用户可能只是想要详细了解他们喜欢的鞋子。因此,用户点击次数是可观察且可量化的指标,可用来训练合适的标签。鞋码是一种可量化的标志,可能对用户是否喜欢推荐的鞋子有很大影响。例如,如果小马穿 43 码的鞋,则该模型不应该推荐 39 码的鞋。合适的特征应该是具体且可量化的。美观程度是一种过于模糊的概念,不能作为实用特征。美观程度可能是某些具体特征(例如样式和颜色)的综合表现。样式和颜色都比美观程度更适合用作特征。喜好不是可观察且可量化的指标。我们能做到最好的就是针对用户的喜好来搜索可观察的代理指标。(总结:具体、可量化的的指标可以作为特征和标签,不可以量化、主观的指标不可以作为特征和标签)
深入了解机器学习 (Descending into ML)
线性回归是一种找到最适合一组点的直线或超平面的方法。本模块会先直观介绍线性回归,为介绍线性回归的机器学习方法奠定基础。
线性回归
人们早就知晓,相比凉爽的天气,蟋蟀在较为炎热的天气里鸣叫更为频繁。数十年来,专业和业余昆虫学者已将每分钟的鸣叫声和温度方面的数据编入目录。Ruth 阿姨将她喜爱的蟋蟀数据库作为生日礼物送给您,并邀请您自己利用该数据库训练一个模型,从而预测鸣叫声与温度的关系。
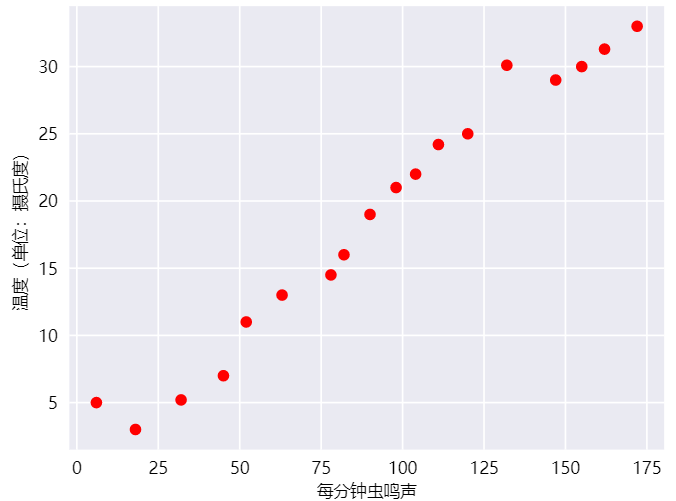 图 1. 每分钟的鸣叫声与温度(摄氏度)的关系
毫无疑问,此曲线图表明温度随着鸣叫声次数的增加而上升。鸣叫声与温度之间的关系是线性关系吗?是的,您可以绘制一条直线来近似地表示这种关系,如下所示:
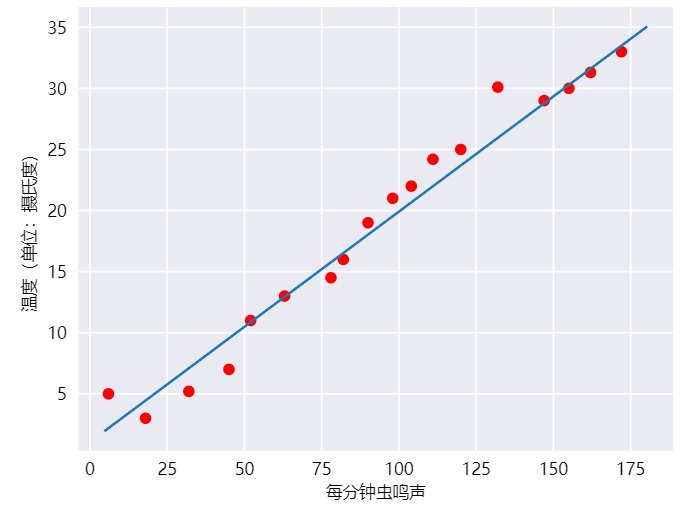 图 2. 线性关系
事实上,虽然该直线并未精确无误地经过每个点,但针对我们拥有的数据,清楚地显示了鸣叫声与温度之间的关系。只需运用一点代数知识,您就可以将这种关系写下来,如下所示:
其中:
- y 指的是温度(以摄氏度表示),即我们试图预测的值。
- m 指的是直线的斜率。
- x 指的是每分钟的鸣叫声次数,即输入特征的值。
- b 指的是 y 轴截距。
按照机器学习的惯例,您需要写一个存在细微差别的模型方程式:
其中:
要根据新的每分钟的鸣叫声值 推断(预测)温度
,只需将
值代入此模型即可。
下标(例如 和
)预示着可以用多个特征来表示更复杂的模型。例如,具有三个特征的模型可以采用以下方程式:
训练与损失
简单来说,训练模型表示通过有标签样本来学习(确定)所有权重和偏差的理想值。在监督式学习中,机器学习算法通过以下方式构建模型:检查多个样本并尝试找出可最大限度地减少损失的模型;这一过程称为经验风险最小化。
损失是对糟糕预测的惩罚。也就是说,损失是一个数值,表示对于单个样本而言模型预测的准确程度。如果模型的预测完全准确,则损失为零,否则损失会较大。训练模型的目标是从所有样本中找到一组平均损失“较小”的权重和偏差。例如,图 3 左侧显示的是损失较大的模型,右侧显示的是损失较小的模型。关于此图,请注意以下几点:
- 红色箭头表示损失。
- 蓝线表示预测。